
Зукърбърг игнорира DeepSeek. Обещава стотици милиарди инвестиции в AI
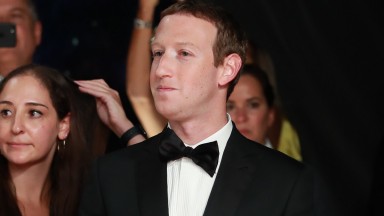
В понеделник американските пазари изпаднаха в паника заради спекулации, че AI моделите на DeepSeek ще сринат търсенето на графични ускорители. Тов доведе до спад на акциите на Nvidia с почти 20%. Но изглежда Meta не „дава заден ход“ заради иновацията на китайския стартъп създал мощен AI с едва 5 милиона долара.
Марк Зукърбърг заяви, че технологичният гигант ще инвестира „много сериозно“ в изкуствения интелект – обещавайки „стотици милиарди долари“ в дългосрочен план. Това той сподели по време на представянето на финансовите резултати на компанията за първото тримесечие в сряда.
Още миналата седмица Зукърбърг обяви, че Meta ще похарчи над 60 милиарда долара само през 2025 г. за капиталови разходи, главно за изграждане на нови центрове за данни.
В отговор на въпрос за влиянието на DeepSeek върху разходите на Meta за AI, Зукърбърг подчерта, че инвестициите в AI инфраструктурата ще останат „стратегическо предимство“ за компанията.
Meta разглежда DeepSeek като нов конкурент и се учи от него, но според Зукърбърг е „твърде рано“ да се каже дали търсенето на чипове ще спре да нараства, тъй като те остават ключови за AI изчисленията.
Той подчерта, че Meta има милиарди потребители и ще продължи да се нуждае от мощна инфраструктура.
„На този етап бих заложил, че способността да изградим такава инфраструктура ще бъде огромно предимство, както за качеството на услугите, така и за мащаба, който искаме да постигнем„, заяви Зукърбърг.
Meta има амбициозна цел с Llama 4 – следващото поколение AI модел на компанията. Според Зукърбърг той ще бъде най-конкурентният в света, дори спрямо затворени модели като ChatGPT. Милиардерът добави, че очаква Llama 4 да притежава автономни AI способности, подобно на разработки от OpenAI и Anthropic, както и мултимодални възможности.
„Нашата цел с Llama 3 беше отвореният код да стане конкурентен спрямо затворените модели„, каза Зукърбърг. „А целта ни за Llama 4 е да водим класацията.“
Успехът на DeepSeek накара мнозина, да припомнят прогнозите си, че увеличаването на мащаба на изчислителната мощност и базите с данни не са гаранция, че моделите ще стават се по-добри.


Post Comment